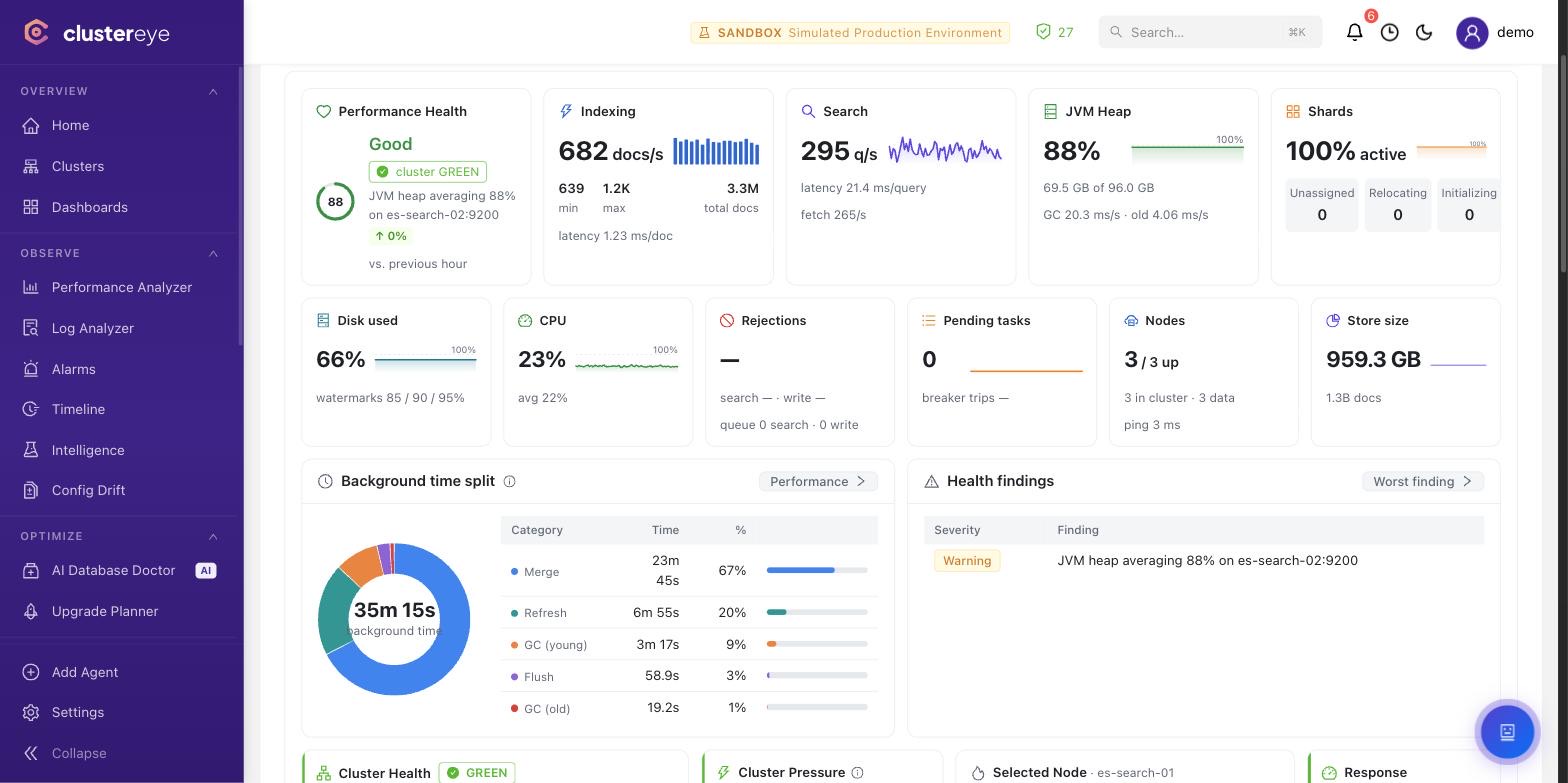
Hangi endpoint'leri okuyoruz
_cluster/health — cluster durumu, atanmamış shard sayısı ve yeniden dengeleme aktivitesi
_cluster/stats — düğüm, indeks, doküman ve depolama toplamları
_nodes/stats — JVM heap, GC süreleri, thread pool reddedilmeleri, circuit breaker tetiklenmeleri
_cat/indices ve _cat/allocation — indeks bazlı boyut, doküman sayısı ve disk dağılımı
<index>/_stats — indeksleme ve arama gecikmesi, refresh ve merge istatistikleri (shard seviyesine kadar)
POST _cluster/allocation/explain — atanmamış shard'ların nedeni (salt-okunur teşhis)
_nodes/http — bağlantı ve HTTP katmanı durumu
Elasticsearch'e özel neler yapıyor
Shard ve allocation teşhisi
Atanmamış shard'lar allocation/explain ile gerekçelendirilir; disk watermark, node filtresi veya replika kısıtı gibi gerçek nedenler isimlendirilir.
Data lifecycle (ILM/tier) analizi
ILM politikalarının ilerleyişi ve tier geçişleri izlenir; adımda takılmış indeksler, yanlış tier'da kalan veri ve büyüyen sıcak katman tespit edilir.
JVM ve baskı göstergeleri
Heap kullanımı, GC duraklamaları, thread pool reddedilmeleri ve circuit breaker tetiklenmeleri birlikte izlenerek düğüm baskısı erken yakalanır.
İndeks performans cockpit'i
İndeksleme ve arama gecikmesi indeks bazında kırılır; en pahalı indeksler, refresh baskısı ve merge yükü öne çıkarılır.
Gereken minimum yetkiler
Baseline salt-okunurdur ve üretimde güvenle verilebilir.
Ön koşullar
·Kullanılan endpoint'ler: _cluster/health, _cluster/stats, _nodes/stats, _nodes/http, _cat/indices, _cat/allocation, <index>/_stats, POST _cluster/allocation/explain.
·Yerleşik monitoring_user rolü YETERSİZDİR (rastgele index'lerde index seviyesinde monitor yetkisi yoktur).
·manage, manage_ilm, manage_index_templates gerekmez. Settings yazımı, reroute, forcemerge yapılmaz.
·OpenSearch: cluster_monitor + indices_monitor (*) ile eşdeğer rol.